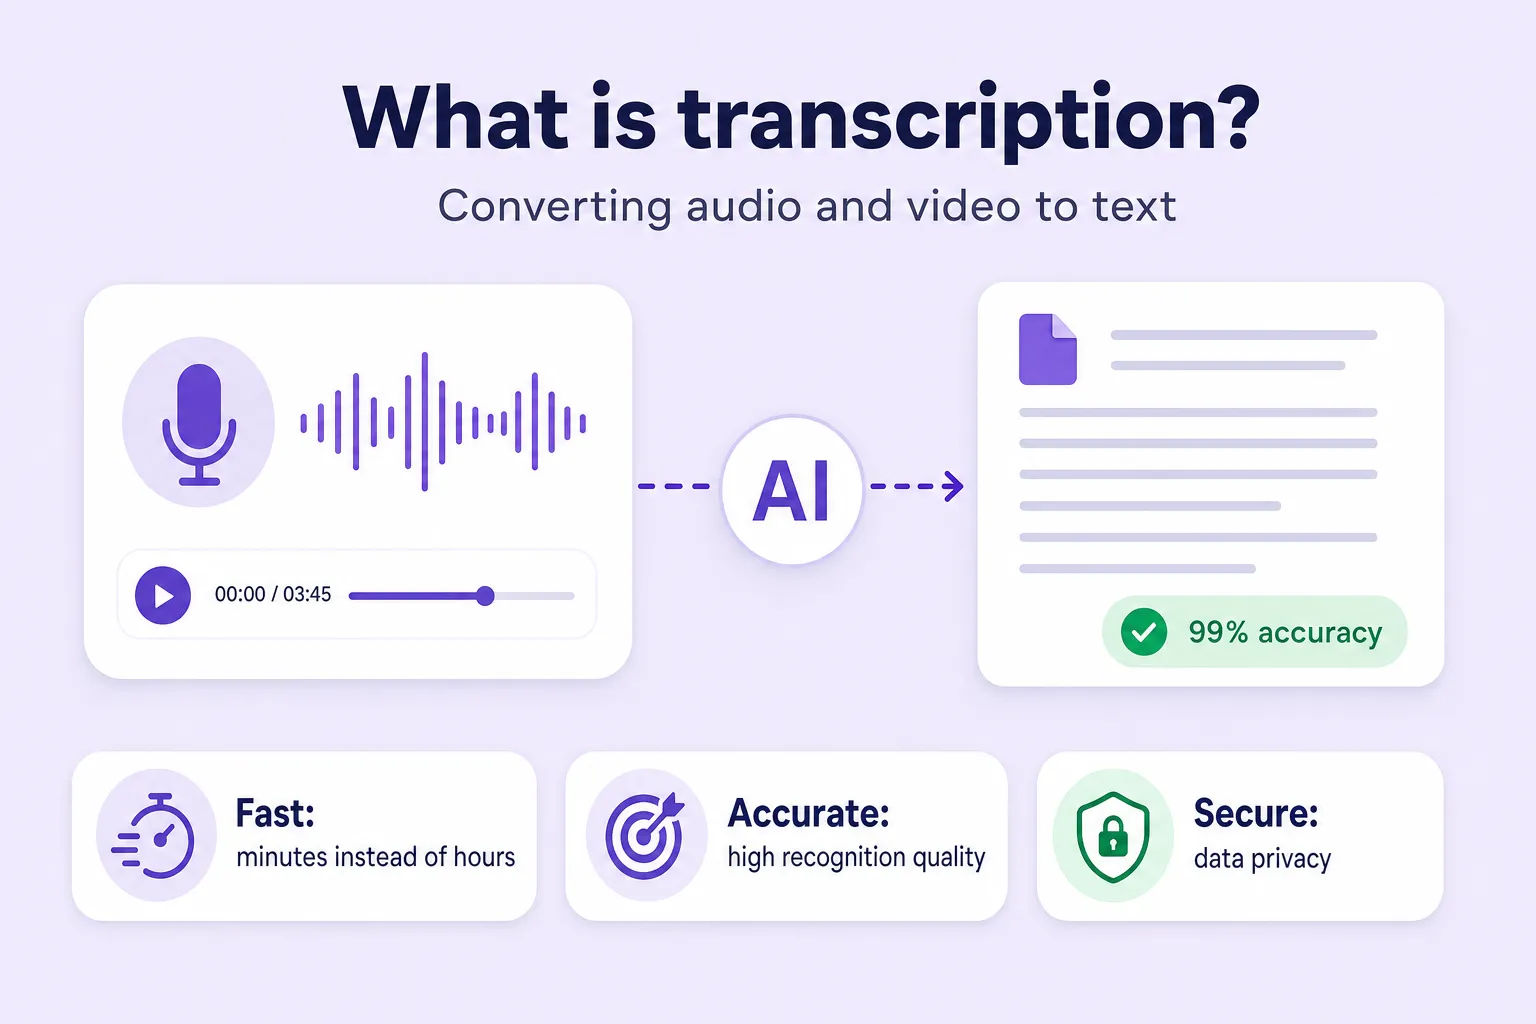
การถอดเสียงคือกระบวนการแปลงคำพูดจากไฟล์เสียงหรือวิดีโอให้กลายเป็นข้อความ การเปลี่ยนเสียงให้เป็นข้อความช่วยให้คุณได้เวอร์ชันข้อความของคำพูดอย่างรวดเร็วและสะดวก เพื่อนำไปวิเคราะห์ จัดเก็บ หรือเผยแพร่ต่อ การถอดเสียงถูกใช้ในหลายวงการ ทั้งงานข่าว การศึกษา ธุรกิจ การแพทย์ และกฎหมาย
โดยแก่นแท้แล้ว การถอดเสียงอาศัยเทคโนโลยีรู้จำเสียง ซึ่งเป็นระบบที่ใช้ปัญญาประดิษฐ์และอัลกอริทึมการเรียนรู้ของเครื่องเพื่อตรวจจับเสียงและเปลี่ยนให้เป็นข้อความโดยอัตโนมัติ การถอดเสียงอัตโนมัติเร็วกว่าการถอดด้วยมือแบบดั้งเดิมอย่างมาก ในขณะที่ยังให้ความแม่นยำสูง ในบทความนี้เราจะดูประเภทหลักของการถอดเสียง วิธีที่เทคโนโลยีรู้จำเสียงทำงาน และขั้นตอนการทำงานกับไฟล์บันทึกเสียง
ประเภทของการถอดเสียง: แบบใช้คนและแบบอัตโนมัติ
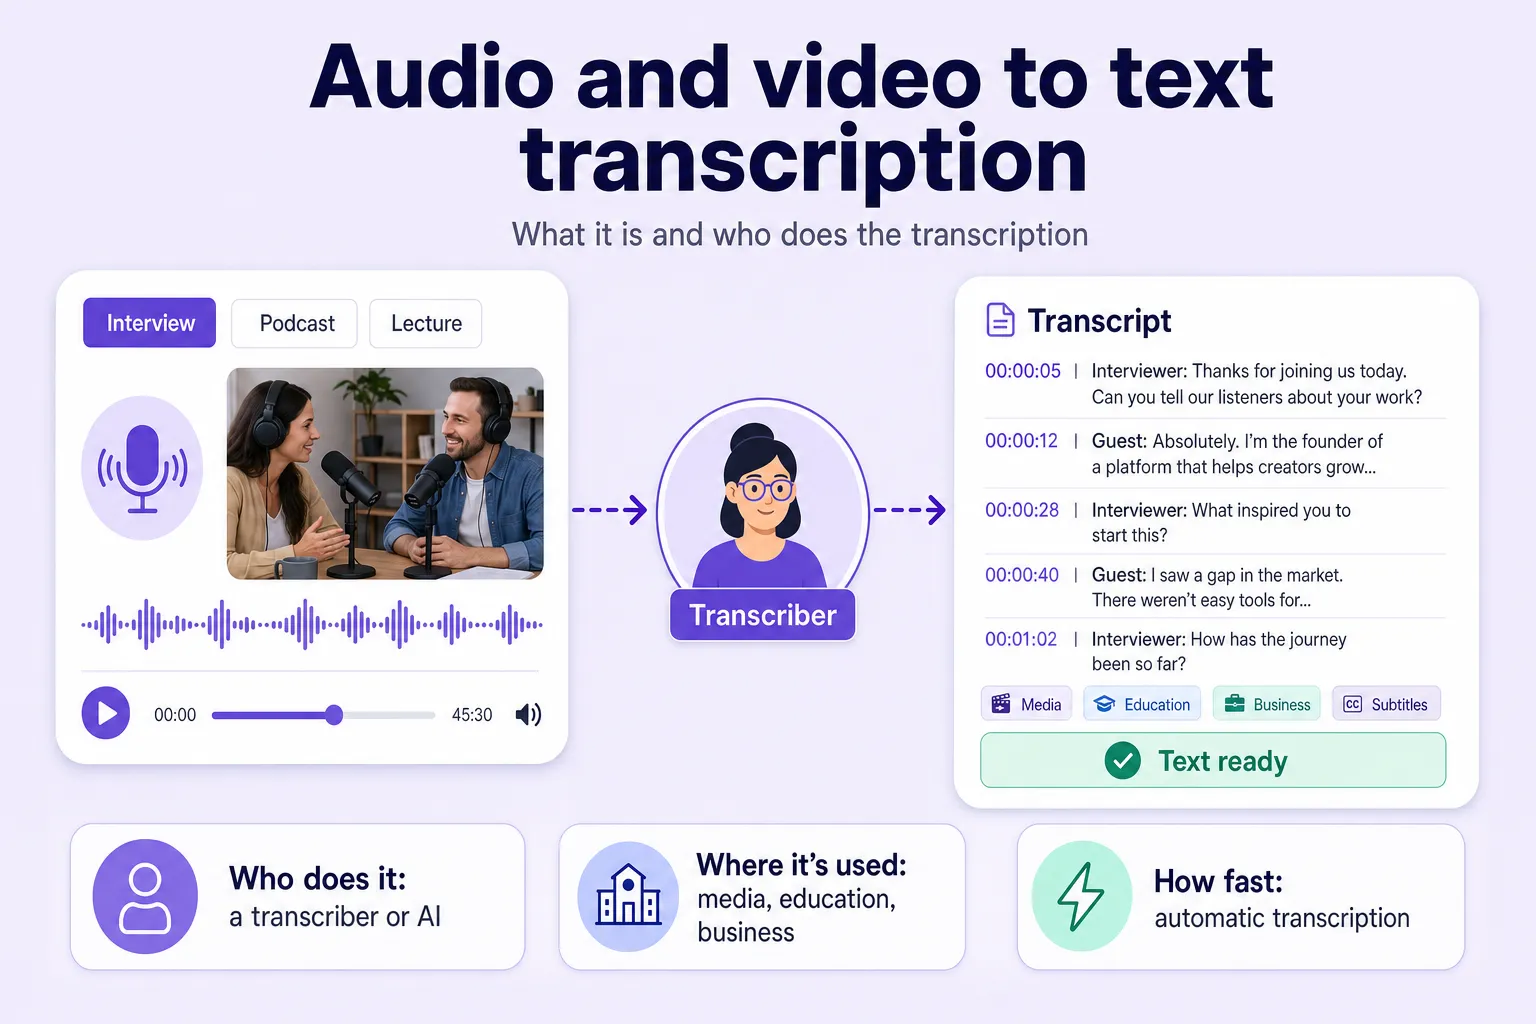
การถอดเสียงและวิดีโอคือกระบวนการแปลงคำพูดที่บันทึกไว้ในรูปแบบเสียงหรือวิดีโอให้เป็นเอกสารข้อความ ซึ่งทำให้คุณได้เวอร์ชันข้อความของบทสัมภาษณ์ การบรรยาย พอดแคสต์ การประชุมทางวิดีโอ และเนื้อหาอื่น ๆ ทำให้ค้นหา วิเคราะห์ และเก็บถาวรข้อมูลได้ง่ายขึ้น
ข้อความนั้นสามารถนำไปใช้สร้างคำบรรยาย จัดทำรายงาน ทำเนื้อหางานวิจัย หรือเพิ่มการเข้าถึงสำหรับผู้ที่หูหนวกหรือมีปัญหาการได้ยิน การแปลงเสียงเป็นข้อความได้กลายเป็นเครื่องมือสำคัญในการสื่อสารยุคใหม่และในการทำงานกับข้อมูลปริมาณมาก
การถอดเสียงมีสองประเภทหลัก ได้แก่ แบบใช้คนและแบบอัตโนมัติ การถอดเสียงแบบใช้คนทำโดยบุคคลที่ตั้งใจฟังไฟล์บันทึกและพิมพ์ข้อความออกมาด้วยมือ วิธีนี้ให้ความแม่นยำสูง โดยเฉพาะกับไฟล์บันทึกที่ยากซึ่งมีเสียงรบกวน มีผู้พูดหลายคน หรือมีศัพท์เฉพาะทาง อย่างไรก็ตาม มันใช้เวลามากและมีค่าใช้จ่ายสูง
การถอดเสียงแบบอัตโนมัติอาศัยการรู้จำเสียงและปัญญาประดิษฐ์ ซอฟต์แวร์และบริการออนไลน์แปลงเสียงเป็นข้อความได้ในเวลาไม่กี่นาที วิธีนี้ประหยัดทั้งเวลาและทรัพยากร แต่ความแม่นยำอาจแตกต่างกันไปตามคุณภาพของไฟล์บันทึกและความซับซ้อนของเนื้อหา
การถอดเสียงแบบอัตโนมัติมักถูกใช้ทำร่างฉบับแรก ซึ่งจากนั้นจะถูกตรวจทานและแก้ไขด้วยมือ
เทคโนโลยีรู้จำเสียงทำงานอย่างไร
เทคโนโลยีรู้จำเสียงคือชุดของอัลกอริทึมและวิธีการที่แปลงคำพูดให้เป็นข้อความโดยอัตโนมัติ กระบวนการเริ่มจากการประมวลผลสัญญาณเสียง โดยเสียงจะถูกแบ่งออกเป็นชิ้นเล็ก ๆ และวิเคราะห์คุณลักษณะของแต่ละชิ้น ทั้งความถี่ แอมพลิจูด และช่วงเวลา จากนั้นระบบจะเทียบสิ่งเหล่านี้กับหน่วยเสียง (phoneme) ซึ่งเป็นหน่วยเสียงที่เล็กที่สุดของภาษา โดยจับคู่เสียงกับรูปแบบที่รู้จักเพื่อประกอบเป็นคำและวลี บริบทและกฎไวยากรณ์ช่วยแก้ข้อผิดพลาดที่อาจเกิดขึ้นและเพิ่มความแม่นยำในการรู้จำ
เมื่อเทคโนโลยีพัฒนาขึ้น จึงมีโมเดลที่ซับซ้อนยิ่งขึ้นซึ่งคำนึงถึงไม่เพียงคุณลักษณะทางเสียง แต่ยังรวมถึงลักษณะทางภาษาศาสตร์ด้วย ซึ่งช่วยยกระดับคุณภาพของการแปลงเสียงเป็นข้อความอย่างมีนัยสำคัญ ระบบเหล่านี้สามารถปรับตัวเข้ากับน้ำเสียง สำเนียง และแม้แต่ภาษาถิ่นที่ต่างกันได้
AI และการเรียนรู้ของเครื่องในการรู้จำเสียง
เทคโนโลยีรู้จำเสียงยุคใหม่ใช้ปัญญาประดิษฐ์ (AI) และการเรียนรู้ของเครื่องอย่างหนัก ระหว่างการฝึก โมเดลจะได้รับข้อมูลเสียงปริมาณมหาศาลพร้อมกับข้อความถอดเสียงที่ถูกต้อง ด้วยการวิเคราะห์ข้อมูลนี้ ระบบจึงเรียนรู้ที่จะรู้จำสำเนียง อัตราการพูด และเสียงรบกวนเบื้องหลังที่แตกต่างกัน รวมถึงแยกผู้พูดหลายคนออกจากกัน
โครงข่ายประสาทเชิงลึกและโมเดลแบบวนซ้ำช่วยให้ระบบประมวลผลลำดับตามเวลาได้อย่างมีประสิทธิภาพ และคาดเดาคำที่น่าจะเป็นไปได้จากบริบท สิ่งนี้สำคัญเป็นพิเศษเมื่อต้องรู้จำไฟล์บันทึกที่ซับซ้อนซึ่งมีผู้พูดหลายคน รวมถึงศัพท์เฉพาะทาง
การใช้ AI ทำให้สามารถปรับปรุงการรู้จำเสียงได้อย่างต่อเนื่อง ลดข้อผิดพลาดและเพิ่มความเร็วในการถอดเสียง โมเดลการเรียนรู้จะแม่นยำและปรับตัวได้ดีขึ้นเมื่อมีประสบการณ์มากขึ้น
ข้อดีและข้อจำกัดของเทคโนโลยีรู้จำเสียง
เทคโนโลยีรู้จำเสียงเร่งการถอดเสียงให้เร็วขึ้นอย่างมากเมื่อเทียบกับการพิมพ์ข้อความด้วยมือ มันสามารถแปลงเสียงปริมาณมากให้เป็นข้อความได้อย่างรวดเร็ว ประหยัดทั้งเวลาและทรัพยากร
อย่างไรก็ตาม ประสิทธิภาพและความแม่นยำขึ้นอยู่กับหลายปัจจัย คุณภาพของไฟล์บันทึกต้นฉบับมีบทบาทสำคัญ: เสียงรบกวน เสียงก้อง และการพูดไม่ชัดล้วนลดความแม่นยำในการรู้จำ สำเนียง ภาษาถิ่น และคนหลายคนพูดพร้อมกันก็สร้างความยากให้กับอัลกอริทึมเช่นกัน ในกรณีเหล่านี้อาจเกิดข้อผิดพลาดและความคลาดเคลื่อนได้ ซึ่งต้องมีการตรวจทานและแก้ไขด้วยมือตามมา
กล่าวโดยสรุป การรู้จำเสียงเป็นเครื่องมือทรงพลัง แต่การจะได้คุณภาพการถอดเสียงที่สูงบางครั้งต้องอาศัยแนวทางแบบผสมผสานที่จับคู่การถอดเสียงอัตโนมัติเข้ากับผู้เชี่ยวชาญที่เป็นคน
การถอดเสียงอัตโนมัติ — ทำงานอย่างไร
การถอดเสียงอัตโนมัติคือกระบวนการแปลงคำพูดให้เป็นข้อความโดยใช้ซอฟต์แวร์เฉพาะทางที่สร้างขึ้นบนเทคโนโลยีรู้จำเสียง ต่างจากการถอดด้วยมือ มันไม่ต้องอาศัยคนในขั้นตอนการแปลง ซึ่งช่วยเร่งการประมวลผลได้อย่างมาก ซอฟต์แวร์จะวิเคราะห์แทร็กเสียงโดยอัตโนมัติ รู้จำคำ และประกอบเป็นข้อความโดยคำนึงถึงไวยากรณ์และลักษณะทางภาษา ผลก็คือมันทำงานด้วยความเร็วสูงแม้กับข้อมูลปริมาณมาก คุณลองด้วยตัวเองได้ด้วยเครื่องมือแปลงเสียงเป็นข้อความและแปลงวิดีโอเป็นข้อความของเรา
ความแม่นยำและคุณภาพของการถอดเสียงอัตโนมัติ
ความแม่นยำของการถอดเสียงอัตโนมัติขึ้นอยู่กับปัจจัยไม่กี่อย่างโดยตรง
อย่างแรก คุณภาพของไฟล์บันทึกต้นฉบับ: เสียงรบกวนเบื้องหลัง เสียงก้อง และการบิดเบือนล้วนทำให้ผลลัพธ์แย่ลง
อย่างที่สอง ความซับซ้อนของคำพูด — ผู้พูดหลายคน จังหวะที่เร็ว สำเนียง และคำสแลง ล้วนทำให้งานของอัลกอริทึมยากขึ้น
ระบบยุคใหม่ใช้โมเดล AI ขั้นสูงที่เรียนรู้จากข้อมูลปริมาณมากและพัฒนาอยู่ตลอดเวลา ถึงกระนั้นก็ยังไม่สามารถกำจัดข้อผิดพลาดได้ทั้งหมด ดังนั้นในงานระดับมืออาชีพจึงมักใช้แนวทางแบบผสม คือถอดเสียงอัตโนมัติแล้วตามด้วยการตรวจทานและแก้ไขด้วยมือ ซึ่งให้ความสมดุลที่ดีที่สุดระหว่างความเร็วและคุณภาพ
ตัวอย่างการใช้บริการถอดเสียงอัตโนมัติ
การถอดเสียงอัตโนมัติถูกนำไปใช้อย่างกว้างขวางในหลายด้านของการทำงาน
ในแวดวงสื่อ มันถูกใช้สร้างเวอร์ชันข้อความของบทสัมภาษณ์ พอดแคสต์ และเนื้อหาวิดีโอ
ในการศึกษา มันช่วยจัดทำโน้ตการบรรยายและสื่อการเรียน
ในธุรกิจ มันถูกใช้บันทึกการประชุม เว็บบินาร์ และการประชุมใหญ่ ทำให้การวิเคราะห์และตัดสินใจในภายหลังง่ายขึ้น
ในทางกฎหมาย การถอดเสียงช่วยจัดทำบันทึกในชั้นศาลและเอกสารต่าง ๆ
บริการยุคใหม่รองรับไฟล์เสียงและวิดีโอหลายรูปแบบ มีอินเทอร์เฟซที่ใช้งานสะดวก และเชื่อมต่อกับเครื่องมืออื่นได้ นั่นจึงเป็นเหตุผลที่การถอดเสียงอัตโนมัติกลายเป็นผู้ช่วยที่ขาดไม่ได้ในการทำงานกับคำพูดและข้อมูลให้ราบรื่นขึ้น คุณสามารถถอดเสียงคำพูดออนไลน์หรือสำรวจชุดเครื่องมือถอดเสียงทั้งหมดได้
การเตรียมและประมวลผลไฟล์เสียง
คุณภาพของเสียงต้นฉบับส่งผลต่อความแม่นยำในการถอดเสียง ก่อนแปลง ควรทำขั้นตอนเตรียมการสักสองสามอย่าง:
- ตรวจไฟล์บันทึกว่ามีเสียงรบกวนเบื้องหลัง เสียงแทรก เสียงก้อง และการบิดเบือนหรือไม่
- หากจำเป็น ให้ประมวลผลเสียงด้วยซอฟต์แวร์ลดเสียงรบกวนและกรองเสียง
- ตรวจให้แน่ใจว่าระดับเสียงและความชัดเจนของคำพูดได้มาตรฐานที่จำเป็นต่อการรู้จำเสียง
การเตรียมการเช่นนี้ช่วยเพิ่มคุณภาพการรู้จำและลดโอกาสเกิดข้อผิดพลาดในข้อความ
รูปแบบไฟล์ก็สำคัญเช่นกัน: บริการยุคใหม่รองรับหลายรูปแบบ แต่บางรูปแบบดีกว่าในแง่คุณภาพและความเร็วในการประมวลผล
รูปแบบไฟล์เสียงและวิดีโอสำหรับการถอดเสียง
ปัจจุบันแพลตฟอร์มถอดเสียงส่วนใหญ่รองรับรูปแบบไฟล์เสียงและวิดีโอยอดนิยม รวมถึง:
- เสียง: MP3, WAV, M4A, AAC, OGG, AIFF, AMR
- วิดีโอ: MP4, MOV, MKV, AVI, FLV
บางแพลตฟอร์มให้คุณอัปโหลดวิดีโอได้โดยตรง โดยดึงแทร็กเสียงออกมาประมวลผลต่อโดยอัตโนมัติ การเลือกรูปแบบที่เหมาะสมและไฟล์บันทึกคุณภาพดีจะทำให้การแปลงเร็วขึ้นและแม่นยำขึ้น
ขั้นตอนการแปลงเสียงเป็นข้อความ
กระบวนการแปลงประกอบด้วยหลายขั้นตอนสำคัญ:
- อัปโหลดไฟล์ คุณอัปโหลดไฟล์เสียงหรือวิดีโอเข้าสู่แพลตฟอร์มถอดเสียงผ่านหน้าเว็บหรือ API
- วิเคราะห์สัญญาณเสียง ระบบประมวลผลแทร็กเสียง แบ่งออกเป็นส่วน ๆ เพื่อเพิ่มความแม่นยำในการรู้จำและทำให้ประมวลผลง่ายขึ้น
- รู้จำเสียง เทคโนโลยีรู้จำเสียง อย่าง AI และอัลกอริทึมการเรียนรู้ของเครื่องเช่น Whisper จาก OpenAI แปลงเสียงเป็นข้อความ โดยคำนึงถึงหลักการออกเสียง ไวยากรณ์ และบริบท
- สร้างเอกสารข้อความ จากคำที่รู้จำได้ ระบบจะประกอบเป็นไฟล์ข้อความ จัดโครงสร้างตามเวลาและตามบล็อกเชิงตรรกะ พร้อมส่งออกเป็นรูปแบบต่าง ๆ เช่น SRT, DOCX, XLSX หรือ TXT
- ตรวจทานและแก้ไข การถอดเสียงอัตโนมัติมักตามด้วยขั้นตอนการแก้ไขซึ่งอาจทำด้วยมือ เพื่อแก้ข้อผิดพลาดที่เกิดจากเสียงรบกวน สำเนียง และคำศัพท์ยาก ๆ
เพื่อเพิ่มความแม่นยำในการถอดเสียง ให้ใช้อุปกรณ์บันทึกที่ดี ควบคุมระดับเสียงรบกวนให้ต่ำ และสำหรับไฟล์บันทึกที่ยาก ให้ผสมการถอดเสียงอัตโนมัติเข้ากับการแก้ไขด้วยมือ