Transkripsjon er prosessen med å gjøre talte ord fra lyd- eller videoopptak om til skriftlig tekst. Å gjøre lyd om til tekst lar deg raskt og enkelt få en tekstversjon av tale til videre analyse, lagring eller publisering. Transkripsjon brukes på tvers av mange felt: journalistikk, utdanning, næringsliv, medisin og juss.
I kjernen bygger transkripsjon på talegjenkjenningsteknologi — et system som bruker kunstig intelligens og maskinlæringsalgoritmer til automatisk å oppdage lyder og gjøre dem om til tekst. Automatisk transkripsjon er dramatisk raskere enn tradisjonell manuell dekoding samtidig som den fortsatt gir høy nøyaktighet. I denne artikkelen ser vi på hovedtypene av transkripsjon, hvordan gjenkjenningsteknologien fungerer og trinnene i arbeidet med lydopptak.
Typer transkripsjon: manuell og automatisk
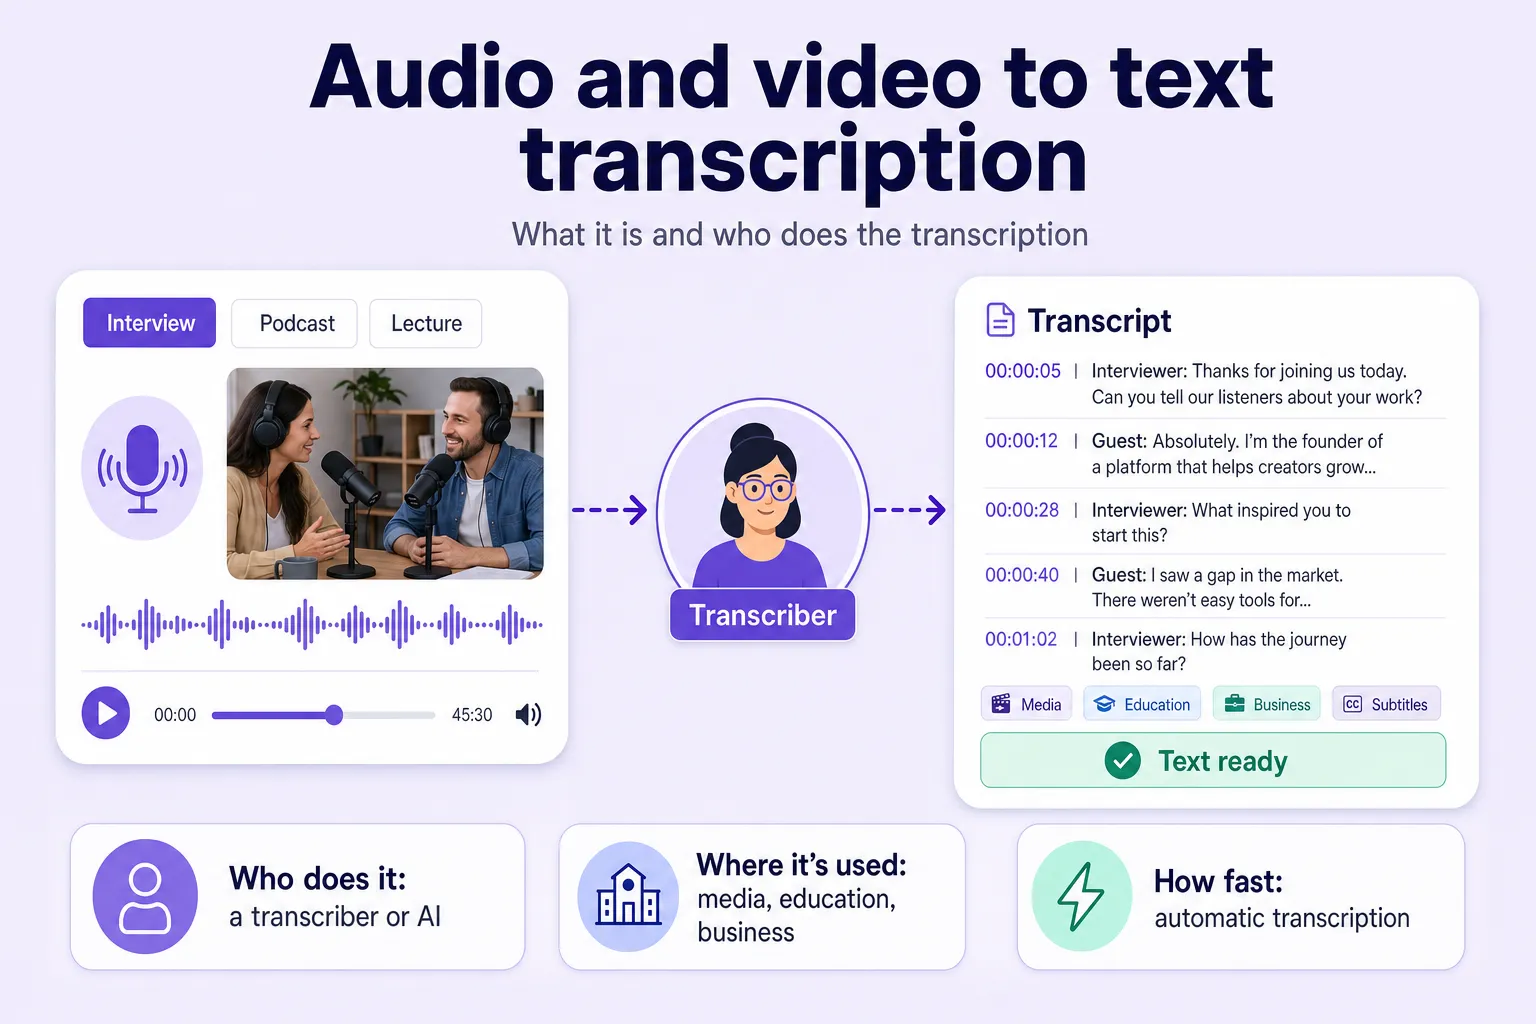
Å transkribere lyd og video er prosessen med å gjøre talte ord, fanget i et lyd- eller videoformat, om til et tekstdokument. Dette gir deg en tekstversjon av intervjuer, forelesninger, podkaster, videokonferanser og annet materiale, noe som gjør informasjon lettere å søke i, analysere og arkivere.
Den teksten kan brukes til å lage undertekster, utarbeide rapporter, undersøke innhold eller forbedre tilgjengeligheten for personer som er døve eller tunghørte. Å gjøre lyd om til tekst har blitt et uunnværlig verktøy i moderne kommunikasjon og i arbeidet med store datamengder.
Det finnes to hovedtyper transkripsjon — manuell og automatisk. Manuell transkripsjon gjøres av et menneske som lytter nøye til et opptak og skriver ut teksten for hånd. Denne tilnærmingen gir høy nøyaktighet, spesielt med vanskelige opptak som inneholder støy, flere talere eller spesialisert terminologi. Den tar imidlertid betydelig tid og har en høy kostnad.
Automatisk transkripsjon bygger på talegjenkjenning og kunstig intelligens. Programvare og nettbaserte tjenester gjør lyd om til tekst på et par minutter. Denne metoden sparer tid og ressurser, men nøyaktigheten kan variere avhengig av opptakets kvalitet og materialets kompleksitet.
Automatisk transkripsjon brukes ofte til et førsteutkast, som deretter gjennomgås og korrigeres for hånd.
Hvordan talegjenkjenningsteknologi fungerer
Talegjenkjenningsteknologi er et sett med algoritmer og metoder som automatisk gjør talt tale om til et tekstformat. Prosessen begynner med behandling av lydsignalet: lyden brytes ned i små biter, og egenskapene til hver av dem analyseres — frekvens, amplitude og tid. Systemet sammenligner deretter disse mot fonemer, de minste lydenhetene i et språk, og matcher lyder til kjente mønstre for å danne ord og fraser. Kontekst og grammatikkregler bidrar til å rette opp mulige feil og forbedre gjenkjenningsnøyaktigheten.
Etter hvert som teknologien har utviklet seg, har mer avanserte modeller dukket opp som tar hensyn ikke bare til akustiske egenskaper, men også til språklige trekk, noe som betydelig forbedrer kvaliteten på tale-til-tekst-konverteringen. Slike systemer kan tilpasse seg ulike stemmer, intonasjoner og til og med dialekter.
AI og maskinlæring i talegjenkjenning
Moderne talegjenkjenningsteknologi gjør utstrakt bruk av kunstig intelligens (AI) og maskinlæring. Under trening mates modellene med enorme mengder lyddata sammen med deres nøyaktige teksttranskripsjoner. Ved å analysere disse dataene lærer systemet å gjenkjenne ulike aksenter, taletempo og bakgrunnsstøy, og å skille flere talere fra hverandre.
Dype nevrale nettverk og rekurrente modeller lar systemer behandle sekvenser over tid effektivt og forutsi sannsynlige ord ut fra konteksten. Dette er spesielt viktig når man gjenkjenner komplekse opptak med flere talere, samt spesialisert terminologi.
Bruk av AI gjør det mulig å kontinuerlig forbedre talegjenkjenning, redusere feil og øke transkripsjonshastigheten. Lærende modeller blir mer nøyaktige og tilpasningsdyktige etter hvert som de får erfaring.
Fordeler og begrensninger ved gjenkjenningsteknologi
Talegjenkjenningsteknologi fremskynder transkripsjon dramatisk sammenlignet med å skrive ut tekst for hånd. Den kan raskt gjøre store mengder lydmateriale om til tekst, og sparer tid og ressurser.
Effektiviteten og nøyaktigheten avhenger imidlertid av flere faktorer. Kvaliteten på kildeopptaket spiller en nøkkelrolle: støy, ekko og utydelig tale reduserer alle gjenkjenningsnøyaktigheten. Aksenter, dialekter og flere personer som snakker samtidig skaper også vanskeligheter for algoritmene. I slike tilfeller er feil og unøyaktigheter mulig, og de krever oppfølgende manuell gjennomgang og korrigering.
Kort sagt er talegjenkjenning et kraftfullt verktøy, men å oppnå høy transkripsjonskvalitet krever noen ganger en kombinert tilnærming som parer automatisk dekoding med menneskelige spesialister.
Automatisk transkripsjon — hvordan det fungerer
Automatisk transkripsjon er prosessen med å gjøre tale om til tekst ved hjelp av spesialisert programvare bygget på talegjenkjenningsteknologi. I motsetning til manuell dekoding krever den ingen menneskelig involvering på konverteringsstadiet, noe som betydelig fremskynder behandlingen. Programvaren analyserer automatisk lydsporet, gjenkjenner ord og danner tekst mens den tar hensyn til grammatikk og språklige trekk. Resultatet er at den jobber med høy hastighet selv med store datamengder. Du kan prøve det selv med våre verktøy for lyd til tekst og video til tekst.
Nøyaktighet og kvalitet ved automatisk transkripsjon
Nøyaktigheten ved automatisk transkripsjon avhenger direkte av noen få faktorer.
For det første kvaliteten på kildeopptaket: bakgrunnsstøy, ekko og forvrengning senker alle resultatet.
For det andre talens kompleksitet — flere talere, et raskt tempo, aksenter og slang kan alle gjøre oppgaven vanskeligere for algoritmene.
Moderne systemer bruker avanserte AI-modeller som lærer av store datamengder og stadig forbedres. Likevel er det ennå ikke mulig å eliminere feil helt, så i profesjonelle sammenhenger er en kombinert tilnærming vanlig — automatisk transkripsjon etterfulgt av manuell gjennomgang og korrigering. Dette gir den beste balansen mellom hastighet og kvalitet.
Eksempler på bruk av automatiske transkripsjonstjenester
Automatisk transkripsjon har funnet bred anvendelse på tvers av mange arbeidsområder.
I mediene brukes det til å lage tekstversjoner av intervjuer, podkaster og videomateriale.
I utdanning bidrar det til å utarbeide forelesningsnotater og studiemateriell.
I næringslivet brukes det til å referatføre møter, webinarer og konferanser, noe som gjør senere analyse og beslutningstaking enklere.
I juridisk praksis bidrar transkripsjon til å produsere rettsprotokoller og dokumenter.
Moderne tjenester støtter mange lyd- og videoformater, tilbyr et brukervennlig grensesnitt og integrerer med andre verktøy. Derfor har automatisk transkripsjon blitt en uunnværlig hjelper for å effektivisere arbeidet med tale og data. Du kan transkribere tale på nett eller utforske hele settet med transkripsjonsverktøy.
Forberedelse og behandling av lydfiler
Kvaliteten på kildelyden påvirker transkripsjonsnøyaktigheten. Før du konverterer, er det verdt å gjøre noen forberedelsestrinn:
- Sjekk opptaket for bakgrunnsstøy, forstyrrende lyder, ekko og forvrengning.
- Behandle om nødvendig lyden med programvare for støyreduksjon og filtrering.
- Pass på at talens volum og tydelighet møter standardene som kreves for gjenkjenning.
Denne typen forberedelse forbedrer gjenkjenningskvaliteten og reduserer sannsynligheten for feil i teksten.
Filformatet betyr også noe: moderne tjenester støtter mange formater, men noen er å foretrekke med tanke på kvalitet og behandlingshastighet.
Lyd- og videoformater for transkripsjon
I dag støtter de fleste transkripsjonsplattformer de populære lyd- og videoformatene, blant annet:
- Lyd: MP3, WAV, M4A, AAC, OGG, AIFF, AMR.
- Video: MP4, MOV, MKV, AVI, FLV.
Noen plattformer lar deg laste opp video direkte, og trekker automatisk ut lydsporet for videre behandling. Å velge riktig format og et opptak av god kvalitet gjør konverteringen raskere og mer nøyaktig.
Trinnene i å gjøre lyd om til tekst
Konverteringsprosessen omfatter flere nøkkeltrinn:
- Opplasting av filen. Du laster opp en lyd- eller videofil til transkripsjonsplattformen gjennom et webgrensesnitt eller API.
- Analyse av lydsignalet. Systemet behandler lydsporet og deler det opp i segmenter for å forbedre gjenkjenningen og forenkle behandlingen.
- Talegjenkjenning. Talegjenkjenningsteknologi — AI- og maskinlæringsalgoritmer som Whisper fra OpenAI — gjør lyden om til tekst, med hensyn til fonetikk, grammatikk og kontekst.
- Bygging av tekstdokumentet. Ut fra de gjenkjente ordene danner systemet en tekstfil, strukturert etter tid og etter logiske blokker, klar til eksport til formater som SRT, DOCX, XLSX eller TXT.
- Gjennomgang og redigering. Automatisk transkripsjon etterfølges ofte av et korrigeringstrinn som kan gjøres for hånd for å rette feil forårsaket av støy, aksenter og vanskelig ordforråd.
For å forbedre transkripsjonsnøyaktigheten, bruk godt opptaksutstyr, hold støynivået nede og, for vanskelige opptak, kombiner automatisk dekoding med manuell redigering.